Vous êtes-vous déjà demandé comment fonctionnent ChatGPT, Gemini ou Claude ? Comment ces intelligences artificielles parviennent-elles à comprendre nos questions et à formuler des réponses parfois aussi pertinentes que celles d'un humain ?
Dans cet article, je vous propose de remonter aux origines d'un LLM en assistant à la naissance de son univers. Au départ, il n'existe rien : ni mots, ni connaissances, le néant. Puis apparaissent les premières étoiles. Au fil de leur évolution, elles vont se déplacer, s'organiser en galaxies, échanger entre elles et, progressivement, faire émerger quelque chose d'extraordinaire : une intelligence capable de comprendre notre langage et de nous répondre.
À la fin de cette lecture, vous comprendrez pourquoi un LLM est capable de répondre à des questions complexes, pourquoi il lui arrive aussi de se tromper ou d'halluciner, et pourquoi l'entraînement de ces modèles nécessite des infrastructures gigantesques.
1. Tout commence par un registre
Avant même de parler d'étoiles ou de galaxies, il nous faut un registre. Pour le remplir, nous allons parcourir une immense bibliothèque de textes : livres, sites web, articles... Bref, tout ce qui peut nous apprendre notre langue.
À mesure de notre lecture, nous allons relever les morceaux de texte qui nous semblent intéressants et leur attribuer un numéro unique. Dans le jargon de l'IA, ces morceaux sont appelés des tokens.
Pour éviter que notre registre ne devienne gigantesque, nous n'enregistrons pas forcément les mots entiers. Nous les découpons en morceaux fréquemment rencontrés. Par exemple, mangerait et regarderait pourraient être découpés en trois tokens : mang, regard et erait.
Vous allez sûrement me dire : « Oui, mais dans ce cas on crée un token de plus ! » Et vous aurez raison. Pourtant, ce système est bien plus efficace que de stocker toutes les conjugaisons de tous les verbes. Le morceau erait n'existe qu'une seule fois dans notre registre et pourra être réutilisé pour des milliers d'autres verbes. Au final, on économise énormément d'espace.
Notre exploration de cette bibliothèque d'Alexandrie moderne est maintenant terminée. Nous possédons un immense registre contenant tous les tokens de notre futur univers.
Pour l'instant, ce ne sont que des noms, aucune étoile ne brille encore dans notre univers.
Il est temps de faire naître nos premières étoiles.
2. La naissance des étoiles
Notre registre est enfin prêt. Nous connaissons le nom de toutes nos futures étoiles, mais une question se pose immédiatement : où les placer dans notre univers ?
Nous aimerions que les étoiles qui évoluent dans les mêmes contextes vivent les unes à côté des autres. Chat et chien apparaissent souvent dans des contextes proches : ils peuvent être des animaux de compagnie, avoir un maître, aller chez le vétérinaire ou manger des croquettes. À l'inverse, camion ou appartement évoluent dans des contextes très différents et se retrouveront donc beaucoup plus loin.
Pour organiser notre univers, nous allons replonger dans notre immense bibliothèque. Cette fois, nous n'allons plus nous intéresser aux mots eux-mêmes, mais à leur vie en société. Quels mots apparaissent souvent ensemble ? Lesquels se croisent régulièrement ? Lesquels ne se rencontrent presque jamais ?
Au fil de cette lecture, notre univers va commencer à prendre forme. Chaque fois que deux mots apparaissent dans des contextes similaires, leurs étoiles se rapprochent légèrement. Chat se rapproche naturellement de chien, mais aussi de lait ou de vétérinaire. À l'inverse, chat croisera beaucoup plus rarement camion ou tournevis, qui resteront plus éloignés.
Petit à petit, des galaxies apparaissent. Les mots qui vivent dans les mêmes contextes finissent par se regrouper. C'est ce que les chercheurs appellent l'hypothèse distributionnelle : « Dis-moi qui tu fréquentes, je te dirai qui tu es. »
Concrètement, chaque étoile reçoit des coordonnées dans notre univers. Elles ressemblent à des coordonnées GPS, sauf qu'au lieu de deux ou trois dimensions, elles en utilisent plusieurs centaines. Grâce à elles, la machine peut mesurer la proximité entre deux étoiles et savoir si deux mots appartiennent au même univers de sens.
Prenons un exemple.
Je me sens très ___
Il avait l'air ___
Les mots heureux, triste ou joyeux peuvent tous compléter ces phrases. Ils finiront donc proches les uns des autres. Non pas parce qu'ils veulent dire exactement la même chose, mais parce qu'ils occupent souvent la même place dans les mêmes contextes.
Notre univers commence enfin à briller de mille feux. Les étoiles se sont organisées, des galaxies sont apparues, et les mots proches vivent désormais les uns à côté des autres.
Mais un dernier problème se présente.
L'étoile chat appartient-elle à la galaxie des animaux... ou à celle de l'informatique ?
Pour l'instant, notre univers est incapable de le savoir. Il va falloir lui apprendre à comprendre le sens d'une phrase, et c'est précisément ce que nous allons découvrir dans la prochaine étape.
Ici nous plaçons ces étoiles à la main, pour l'intuition ; en réalité, ce placement et tout le reste émergeront d'un seul et même entraînement — on y reviendra.
3. Mise en relation des étoiles
Notre univers commence à prendre forme. Les étoiles se sont organisées en galaxies et les mots qui évoluent dans les mêmes contextes vivent désormais les uns à côté des autres. Pourtant, un problème de taille subsiste : une étoile ne représente toujours qu'un seul mot.
Prenons chat. Parle-t-on de Maya, mon chat, ou de la discussion Teams que j'ai eue ce matin ? Pour nous, la différence est évidente, car nous comprenons naturellement le contexte. Notre univers, lui, ne voit qu'une seule étoile nommée chat. Il va donc falloir lui donner un moyen de tenir compte des autres étoiles présentes dans la phrase.
Pour cela, imaginons que chaque étoile émette en permanence trois ondes : une onde-question, qui demande « Qui peut m'aider ? », une onde-étiquette, qui répond « Voilà le type d'information que je peux t'apporter », et une onde-transport, qui contient cette information.
Prenons maintenant la phrase : Maya, mon chat, réclame ses croquettes.
Notre univers ne regarde pas toutes les étoiles qu'il connaît. Il ne s'intéresse qu'à celles présentes dans la phrase. Et surtout, à chaque étoile, il ne montre que celles qui la précèdent : pour apprendre à deviner la suite d'un texte, on ne s'autorise jamais à lire vers la fin. Quand notre univers arrive sur l'étoile chat, celle-ci ne peut donc interroger que Maya et mon, placées avant elle.
L'étoile chat envoie son onde-question. Les étoiles qui la précèdent répondent avec leur onde-étiquette. Si une réponse semble pertinente, un lien plus fort se crée entre les deux étoiles. Ce lien ne sert pas à déplacer les étoiles dans notre univers ; il sert uniquement à décider de l'importance que l'on accordera à l'information qu'elles transportent.
Ici, Maya et mon ont beaucoup à raconter à chat : ils la rattachent sans hésiter à la galaxie des animaux. L'étoile chat récupère donc une grande partie de leur onde-transport. À la fin de cette étape, elle est toujours à la même place dans notre univers, mais elle porte désormais une information enrichie par son contexte.
Si nous remplaçons la phrase par : J'ai posté un message sur le chat.
Le mécanisme est exactement le même, mais les étoiles qui précèdent chat sont différentes. Cette fois, ce sont posté, message et sur qui l'influencent, et l'étoile bascule vers la galaxie de l'informatique. Elle n'a pourtant jamais changé de place : c'est uniquement l'information qu'elle transporte qui a changé.
Cette information enrichie est temporaire. Une fois la réponse générée, notre univers retrouve son état initial. Les étoiles ne se déplacent jamais ; elles repartent toujours de leur position d'origine pour analyser la phrase suivante.
C'est d'ailleurs une différence fondamentale entre un LLM et nous. Là où nous nous appuyons sur notre mémoire, un LLM s'appuie sur son contexte. À chaque nouveau mot qu'il génère, il relit l'ensemble du contexte qui lui est fourni — la conversation, un document ou un extrait de texte — puis recommence ce mécanisme d'échange entre les étoiles. Il ne mémorise pas la conversation : il la réanalyse en permanence.
Notre univers est maintenant capable de faire dialoguer ses étoiles. Il lui manque cependant une dernière pièce du puzzle : il ne sait toujours pas dans quel ordre elles apparaissent. Les phrases « Le chien mord l'homme » et « L'homme mord le chien » contiennent exactement les mêmes étoiles, mais ne racontent évidemment pas la même histoire. Il est temps d'introduire la notion de position.
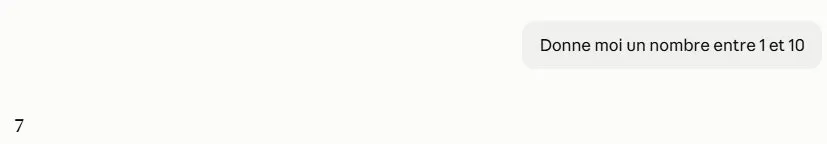
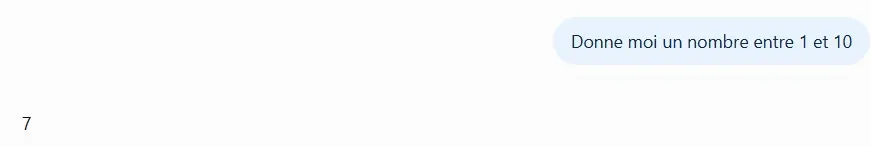
Pour illustrer ce fonctionnement, je vous propose une petite expérience. Prenez trois LLM — Gemini, Claude et ChatGPT par exemple — et posez-leur cette simple question : « Donne-moi un nombre entre 1 et 10. »
Vous devriez obtenir trois fois la même réponse : 7. Pas parce que les IA se sont concertées, mais parce que, compte tenu de leur entraînement, c'est la réponse qui ressort comme la plus probable.
4. Donner un ordre aux étoiles
Notre univers est maintenant capable de faire dialoguer les étoiles. Pourtant, il lui manque encore une information essentielle : leur position.
En effet, les ondes ne savent pas où se trouve une étoile dans une phrase. Elles savent seulement avec quelles autres étoiles elle échange. Pour elles, les phrases « Le chien mord l'homme » et « L'homme mord le chien » sont composées exactement des mêmes étoiles. Sans autre information, elles seraient donc impossibles à distinguer.
Pour résoudre ce problème, nous allons ajouter une petite étiquette à chaque étoile avant qu'elle n'entre dans notre univers. Cette étiquette indique simplement sa position dans la phrase. L'étoile chat ne se présente donc plus seule : elle arrive accompagnée de son numéro de siège.
Grâce à cette information, deux étoiles pourtant identiques ne seront plus vues de la même manière si elles occupent des positions différentes. Un chat placé au début de la phrase ne sera plus tout à fait le même qu'un chat placé à la fin, et les échanges entre les étoiles pourront enfin tenir compte de l'ordre des mots.
Notre univers est désormais capable de distinguer « Le chien mord l'homme » de « L'homme mord le chien ». Les mêmes étoiles sont présentes, mais leur organisation raconte une histoire complètement différente.
5. Un univers qui apprend
On parle souvent d'entraînement pour les LLM et de son impact énergivore et écologique à juste titre.
Avec beaucoup de GPU pouvant traiter des milliers de calculs simultanés nous lui faisons lire notre immense bibliothèque. Le principe est toujours le même : nous lui montrons le début d'une phrase et nous lui demandons de deviner le mot suivant.
Cette immense usine n'a qu'un seul objectif : déplacer légèrement les étoiles et ajuster les recettes afin que le prochain mot devienne, petit à petit, plus facile à deviner. Des milliers de positions sont traitées en même temps, c’est ce parallélisme que la technologie a su exploiter ces dernières années pour digérer d’énormes corpus.
Prenons « … il rentre. Le chat boit du lait. Elle sourit et … » (remarquez que l’extrait n’est pas une phrase mais un flot de mots continu).
Sur le tout premier token du bloc, sans contexte à gauche et avec des positions au hasard, la machine ne peut produire que des pourcentages minuscules et quasi égaux pour tout le monde (~0,0001 % chacun) : « il » n’est pas plus probable qu’un autre. Erreur énorme, grosse correction.
À la position suivante, un autre calcul interprète « il » et doit deviner « rentre ». Il se trompe, donc il ajuste les recettes ET les positions d’étoiles d’un chouïa pour que le vrai mot suivant devienne plus probable après ce contexte.
Au bout d’un certain temps, on a des statistiques fortes qui permettent à l’IA d’écrire des phrases cohérentes.
Tout cela reste un peu abstrait. Construisons donc un univers miniature pour voir ce qui se passe.
Prenons un petit corpus de 124 tokens :
le chat boit du lait . le chat mange la souris . le chien mange la viande .
le chien boit de l eau . la souris mange le fromage . (× 4)
Vocabulaire (15 tokens) : . boit chat chien de du eau fromage l la lait le mange souris viande
Au démarrage, toutes les étoiles sont au même point, les stats sont identiques :
après « le » → chien 6,7 % . 6,7 % lait 6,7 % l 6,7 % la 6,7 %
après « . » → fromage 6,7 % . 6,7 % la 6,7 % le 6,7 % eau 6,7 %
après « boit » → . 6,7 % fromage 6,7 % la 6,7 % de 6,7 % lait 6,7 %
Tous les mots sont à 6,7 %, soit 1/15 : chacun à valeur égale.
Ensuite on itère. À chaque itération, la machine mesure le pourcentage qu’elle a donné au bon mot : gros pourcentage → elle est dans le vrai → petit ajustement ; petit pourcentage → elle est dans le faux → gros ajustement (positions des étoiles et recettes).
Après ~2000 itérations, l’erreur moyenne est tombée de 2,7 à 0,56, et les statistiques ont émergé :
après « le » → chien 40 % chat 40 % fromage 20 %
après « . » → le 79 % la 21 %
après « boit » → du 50 % de 50 %
On est passé de « tout à 6,7 % » à des pourcentages qui reflètent les vraies fréquences du corpus. La machine n’a pas mémorisé une réponse unique : elle a appris la distribution réelle. Et l’erreur ne tombe pas à zéro (elle se coince vers 0,56) parce que certaines suites sont vraiment ambiguës : après « boit », « du » et « de » sont aussi vrais l’un que l’autre — donc 50/50 est la perfection, pas un défaut.
Les pourcentages ne sont là que pour nous aider à visualiser ce qu'il se passe. Dans la réalité, le modèle ne stocke jamais de probabilités. Il ne connaît que la position de ses étoiles et ses recettes. À chaque nouveau mot, il refait tous les calculs et les probabilités apparaissent naturellement.
Si vous vous demandiez pourquoi nous avons passé autant de temps à placer les étoiles et à fabriquer leurs ondes, la réponse est maintenant simple : c'est précisément ce que l'entraînement apprend.
6. Apprendre à assister
Notre univers est maintenant capable d'écrire des phrases cohérentes. Si je lui donne le début d'un texte, il est capable d'en imaginer une suite qui a du sens. Pourtant, il lui manque encore quelque chose d'essentiel : il ne sait pas tenir une conversation.
Pour lui, une question est simplement un morceau de texte. Si je lui demande « Quelle est la capitale de la France ? », rien ne l'incite à répondre. Il pourrait tout aussi bien continuer la phrase avec une autre question ou partir sur un sujet complètement différent.
C'est là qu'intervient le fine-tuning.
Les étoiles sont déjà en place, les recettes fonctionnent et notre modèle connaît déjà la langue. Nous allons simplement lui faire lire une nouvelle bibliothèque, beaucoup plus petite, composée cette fois de conversations soigneusement sélectionnées.
Au lieu de lui montrer des livres ou des articles, nous lui montrons des échanges du type :
Utilisateur : Quelle est la capitale de la France ? Assistant : La capitale de la France est Paris.
Le principe d'apprentissage ne change pas. Le modèle continue de deviner le mot suivant, de mesurer son erreur et d'ajuster légèrement les positions de ses étoiles ainsi que ses recettes. En revanche, le type de texte qu'il lit est complètement différent. Petit à petit, il comprend qu'après le mot Assistant :, on attend une réponse utile et non la simple continuation d'un texte.
Cette première étape, appelée Supervised Fine-Tuning (SFT), ne lui apprend pratiquement aucun fait nouveau. Paris était déjà la capitale de la France dans son univers. En revanche, elle lui apprend comment utiliser ce qu'il sait pour répondre à un humain.
Une fois cette étape terminée, il reste une dernière question : parmi toutes les réponses possibles, laquelle est la meilleure ?
Pour y répondre, on fait intervenir des humains. On leur présente plusieurs réponses générées par le modèle et on leur demande de les classer. Certaines sont plus claires, d'autres plus utiles, plus honnêtes ou plus prudentes. Le modèle apprend progressivement à préférer ce style de réponse. Cette étape est connue sous le nom de RLHF ou, plus récemment, de DPO, deux méthodes qui poursuivent le même objectif : aligner le comportement du modèle avec ce que nous attendons de lui.
Et là on va pouvoir comprendre pourquoi on parle d’hallucination du modèle ?
Lorsqu'un modèle invente une réponse, ce n'est généralement pas parce que le fine-tuning lui a appris une fausse information. C'est parce que son univers ne possède pas suffisamment de connaissances sur le sujet ou qu'elles sont mal organisées. Le fine-tuning lui a simplement appris à répondre avec assurance, même lorsqu'il lui manque des éléments. C'est cette combinaison qui produit une réponse parfaitement crédible... mais parfois totalement fausse.
Et c'est probablement le point le plus surprenant de toute cette histoire. Derrière les réponses parfois bluffantes de ChatGPT ou de Claude ne se cache ni une conscience, ni une intelligence qui raisonne comme nous. Seulement un univers d'étoiles patiemment façonné, qui échange de l'information, calcule des probabilités et choisit, mot après mot, la suite la plus cohérente. C'est finalement de cette mécanique, aussi simple dans son principe que gigantesque dans son exécution, qu'émerge ce que nous appelons aujourd'hui un large language model.
Conclusion
Au début de cet article, nous nous demandions comment une machine pouvait comprendre notre langue et produire des réponses parfois aussi pertinentes que celles d'un humain.
La réponse est finalement moins mystérieuse qu'elle n'y paraît. C’est un apprentissage de notre langue et finalement une certaine forme de mimétisme. Mais quelque part c’est assez proche de l’apprentissage d’une langue par un enfant.
C'est probablement ce qui rend les LLM si fascinants. Des règles finalement assez simples, répétées des milliards de fois, finissent par produire un comportement qui ressemble étonnamment à de l'intelligence.
Mais ce n'est que le début de l'histoire.
Car une question reste entière : si un LLM se contente de prédire le mot suivant, comment est-il capable de résoudre un problème de mathématiques, d'écrire un programme informatique ou de construire un raisonnement complexe ?